Dein LLM,in einer Box.
Mini-PCs, die Llama, Qwen, Gemma und gpt-oss bei dir zuhause ausführen. Wähl ein Modell und sieh, welche Box es schafft und wie schnell sie antwortet.
Passende Box finden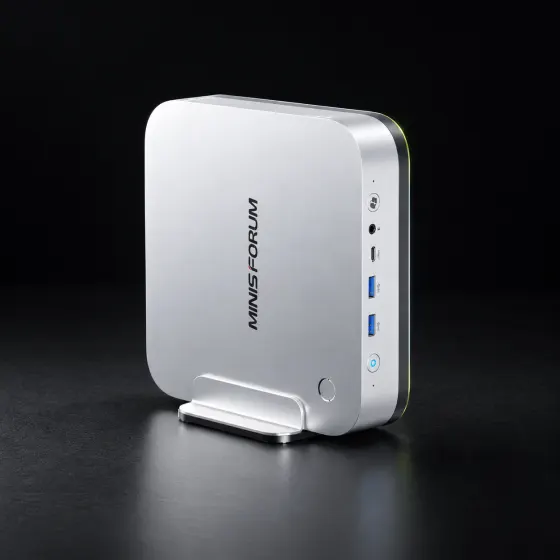
Die DSGVO regelt, wie Unternehmen in der EU personenbezogene Daten erheben, speichern und verarbeiten dürfen. Jede Verarbeitung braucht eine Rechtsgrundlage, Betroffene haben Rechte auf Auskunft, Berichtigung und Löschung, und die Daten müssen angemessen geschützt werden. Läuft das Modell auf deiner eigenen Box, verlassen die Daten dein Netzwerk gar nicht erst.
Jedes offene Modell,
auf einer Tafel.
22 Modelle, sortiert nach Speicherbedarf. Rechts steht der kleinste Tier, auf dem es brauchbar läuft, daneben das Tempo dort; gelbes Tempo heißt: es passt, bleibt aber zäh. Tipp auf eine Zeile für Details.
Gemma 4 E2B2B2 GB~29 tok/sStarter
Winzig und erstaunlich gut. Läuft auch auf dem kleinsten Gerät als Assistent im Hintergrund.
- Chat
Läuft auf 10 von 10 Boxen, ab 839 € (GEEKOM A8 Max 16 GB)Am schnellsten: ~100 tok/s auf Apple Mac mini M5 Pro 24 GBollama run gemma4:e2bIm Konfigurator prüfenPhi-4 Mini3,8B2,5 GB~23 tok/sStarter
Microsofts kleines Rechen- und Logikmodell, schnell auf jeder Box.
- Chat
- Denken
Läuft auf 10 von 10 Boxen, ab 839 € (GEEKOM A8 Max 16 GB)Am schnellsten: ~80 tok/s auf Apple Mac mini M5 Pro 24 GBollama run phi4-miniIm Konfigurator prüfenLlama 3.1 8B8B4,9 GB~12 tok/sStarter
Der Klassiker zum Einstieg, riesiges Ökosystem an Feintunings.
- Chat
Läuft auf 10 von 10 Boxen, ab 839 € (GEEKOM A8 Max 16 GB)Am schnellsten: ~41 tok/s auf Apple Mac mini M5 Pro 24 GBollama run llama3.1:8bIm Konfigurator prüfenQwen3 8B8B5,2 GB~11 tok/sStarter
Denkt auf Wunsch Schritt für Schritt und kann Werkzeuge aufrufen.
- Chat
- Denken
- Agenten
Läuft auf 10 von 10 Boxen, ab 839 € (GEEKOM A8 Max 16 GB)Am schnellsten: ~38 tok/s auf Apple Mac mini M5 Pro 24 GBollama run qwen3:8bIm Konfigurator prüfenGemma 3 12B12B8,1 GB~25 tok/sStarter
Liest auch Bilder und Screenshots, 128k Kontext.
- Chat
- Bilder
Läuft auf 10 von 10 Boxen, ab 1 832 € (Apple Mac mini M5 Pro 24 GB)Am schnellsten: ~25 tok/s auf Apple Mac mini M5 Pro 24 GBollama run gemma3:12bIm Konfigurator prüfenPhi-4 14B14B9,1 GB~22 tok/sStarter
Stark bei Mathe und Logik für seine Größe.
- Denken
Läuft auf 9 von 10 Boxen, ab 1 832 € (Apple Mac mini M5 Pro 24 GB)Am schnellsten: ~22 tok/s auf Apple Mac mini M5 Pro 24 GBollama run phi4:14bIm Konfigurator prüfenQwen3 14B14B9,3 GB~21 tok/sStarter
Guter Alltagsassistent, auch für Code-Fragen.
- Chat
- Denken
- Code
Läuft auf 9 von 10 Boxen, ab 1 832 € (Apple Mac mini M5 Pro 24 GB)Am schnellsten: ~21 tok/s auf Apple Mac mini M5 Pro 24 GBollama run qwen3:14bIm Konfigurator prüfengpt-oss-20b21B, 3,6B aktiv13 GB~24 tok/sStarter
OpenAIs kleines offenes Modell. Mixture-of-Experts: groß im Wissen, schnell im Antworten.
- Chat
- Denken
- Agenten
Läuft auf 9 von 10 Boxen, ab 1 399 € (Minisforum AI X1 Pro 32 GB)Am schnellsten: ~83 tok/s auf Apple Mac mini M5 Pro 24 GBollama run gpt-oss:20bIm Konfigurator prüfenDevstral Small 24B24B14 GB~14 tok/sStarter
Mistrals Coding-Agent fürs eigene Repository, Apache-2.0-Lizenz.
- Code
- Agenten
Läuft auf 9 von 10 Boxen, ab 1 832 € (Apple Mac mini M5 Pro 24 GB)Am schnellsten: ~14 tok/s auf Apple Mac mini M5 Pro 24 GBollama run devstral:24bIm Konfigurator prüfenMistral Small 3.224B15 GB~13 tok/sStarter
Europäisches Modell, sehr gutes Deutsch, liest Bilder.
- Chat
- Bilder
- Deutsch
Läuft auf 9 von 10 Boxen, ab 1 832 € (Apple Mac mini M5 Pro 24 GB)Am schnellsten: ~13 tok/s auf Apple Mac mini M5 Pro 24 GBollama run mistral-small3.2:24bIm Konfigurator prüfenGemma 4 26B26B, 4B aktiv16 GB~23 tok/sStarter
Googles aktuelles MoE-Modell: Qualität der 27B-Klasse bei der Geschwindigkeit eines kleinen Modells.
- Chat
- Bilder
- Denken
Läuft auf 8 von 10 Boxen, ab 1 399 € (Minisforum AI X1 Pro 32 GB)Am schnellsten: ~68 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run gemma4:26bIm Konfigurator prüfenGemma 3 27B27B17 GB~10 tok/sPro
Dense, multimodal, sehr solide auf Deutsch.
- Chat
- Bilder
- Deutsch
Läuft auf 8 von 10 Boxen, ab 2 000 € (GMKtec EVO-X2 64 GB)Am schnellsten: ~10 tok/s auf GMKtec EVO-X2 64 GBollama run gemma3:27bIm Konfigurator prüfenQwen3.8 27B27B17 GB~10 tok/sPro
Das neueste Qwen in Dense-Bauweise, eines der stärksten Modelle unter 32B.
- Chat
- Code
- Denken
Läuft auf 8 von 10 Boxen, ab 2 000 € (GMKtec EVO-X2 64 GB)Am schnellsten: ~10 tok/s auf GMKtec EVO-X2 64 GBollama run qwen3.8:27bIm Konfigurator prüfenQwen3 30B-A3B30B, 3B aktiv19 GB~29 tok/sStarter
Braucht 19 GB, antwortet aber so schnell wie ein 3B-Modell. Liebling der Strix-Halo-Besitzer.
- Chat
- Denken
- Agenten
Läuft auf 8 von 10 Boxen, ab 1 399 € (Minisforum AI X1 Pro 32 GB)Am schnellsten: ~89 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run qwen3:30bIm Konfigurator prüfenQwen3-Coder 30B30B, 3B aktiv19 GB~29 tok/sStarter
Schneller Coding-Assistent für den Editor, 256k Kontext.
- Code
- Agenten
Läuft auf 8 von 10 Boxen, ab 1 399 € (Minisforum AI X1 Pro 32 GB)Am schnellsten: ~89 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run qwen3-coder:30bIm Konfigurator prüfenLaguna XS 2.133B, 3B aktiv20 GB~29 tok/sStarter
Poolsides offenes Coding-Modell für Agenten-Workflows.
- Code
- Agenten
Läuft auf 8 von 10 Boxen, ab 1 399 € (Minisforum AI X1 Pro 32 GB)Am schnellsten: ~89 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run laguna-xs-2.1Im Konfigurator prüfenQwen3 32B32B20 GB~8 tok/sPro
Dense und gründlich; braucht Bandbreite, dafür konstant hohe Qualität.
- Chat
- Denken
Läuft auf 8 von 10 Boxen, ab 2 000 € (GMKtec EVO-X2 64 GB)Am schnellsten: ~9 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run qwen3:32bIm Konfigurator prüfenLlama 3.3 70B70B42,5 GB~4 tok/sPro
Die klassische 70B-Klasse. Passt ab 64 GB, ist dort aber geduldig.
- Chat
- Deutsch
Läuft auf 7 von 10 Boxen, ab 2 000 € (GMKtec EVO-X2 64 GB)Am schnellsten: ~4 tok/s auf GMKtec EVO-X2 64 GBollama run llama3.3:70bIm Konfigurator prüfengpt-oss-120b117B, 5B aktiv65 GB~46 tok/sMax
OpenAIs großes offenes Modell. Der Grund, warum sich 128 GB lohnen.
- Chat
- Denken
- Agenten
Läuft auf 4 von 10 Boxen, ab 3 450 € (GMKtec EVO-X2 128 GB)Am schnellsten: ~49 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run gpt-oss:120bIm Konfigurator prüfenLlama 4 Scout109B, 17B aktiv67 GB~16 tok/sMax
Metas MoE mit 16 Experten und langem Kontext, liest Bilder.
- Chat
- Bilder
Läuft auf 4 von 10 Boxen, ab 3 450 € (GMKtec EVO-X2 128 GB)Am schnellsten: ~17 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run llama4:scoutIm Konfigurator prüfenGLM-4.5 Air106B, 12B aktiv68 GB~22 tok/sMax
Starkes Agenten- und Coding-Modell, nur für 128-GB-Boxen.
- Code
- Agenten
Läuft auf 4 von 10 Boxen, ab 3 450 € (GMKtec EVO-X2 128 GB)Am schnellsten: ~24 tok/s auf ASUS Ascent GX10 (DGX Spark) 128 GBollama run glm-4.5-airIm Konfigurator prüfenQwen3 235B-A22B235B, 22B aktiv142 GB–zu groß
Zu groß für eine einzelne Box: dafür braucht es zwei gekoppelte 128-GB-Geräte oder einen Mac Studio mit 256 GB.
- Chat
- Denken
- Code
Läuft auf 0 von 10 Boxenollama run qwen3:235b
- GMKtec EVO-X2 64 GB~64 tok/s2 000 €
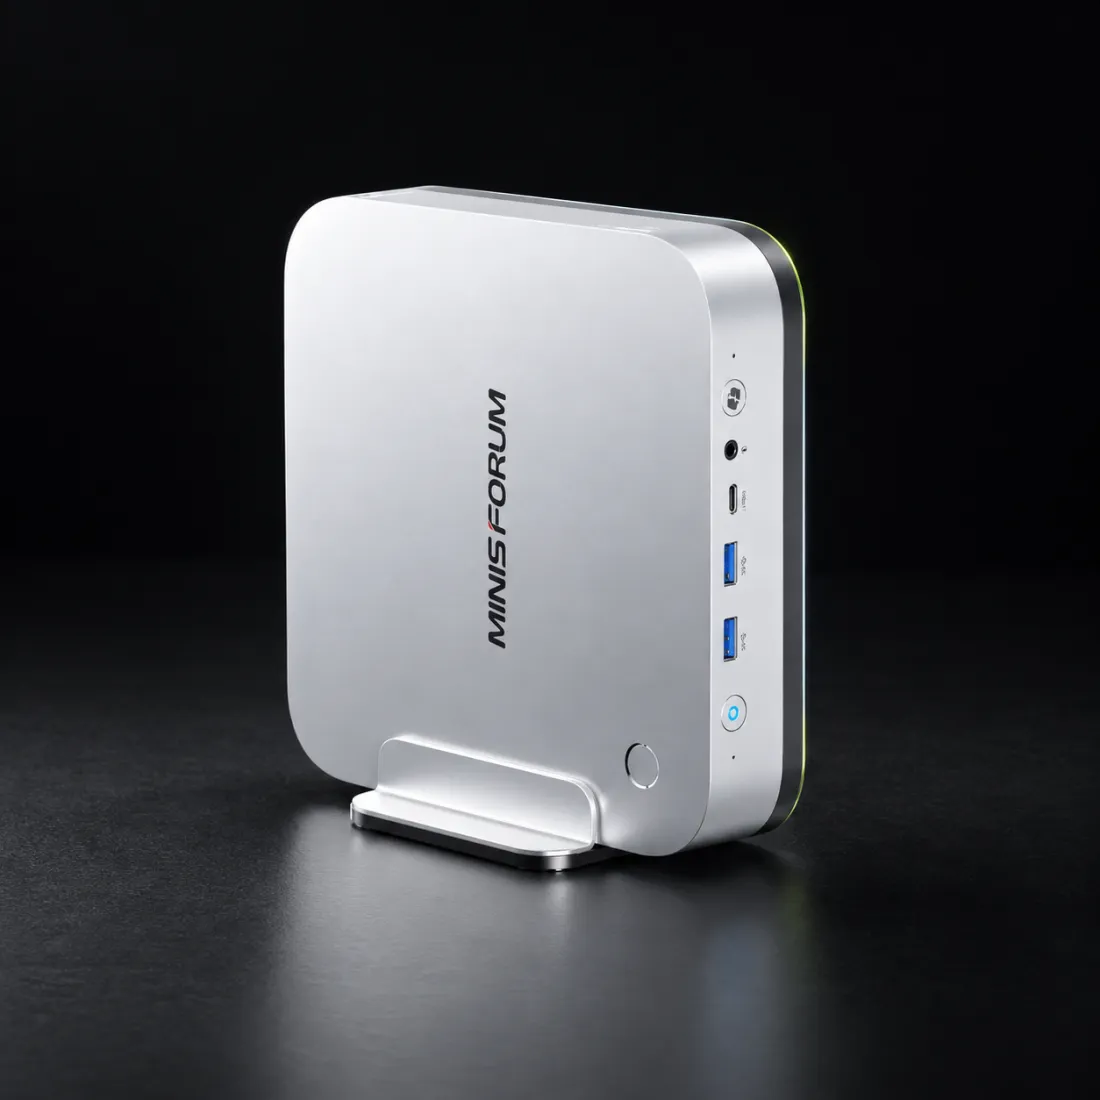
- Minisforum AI X1 Pro 96 GB~23 tok/s2 149 €
- GEEKOM A9 Mega 64 GB~64 tok/s2 499 €
Deine Box in
fünf Fragen.
Wofür brauchst du es?
Wir schlagen pro Zweck ein starkes Modell vor und filtern die Liste darunter.
Welches Modell?
Größe in 4 Bit. MoE-Modelle brauchen viel Speicher, antworten aber schnell, weil pro Token nur ein Teil rechnet.
ollama run gemma4:26bWie viele fragen gleichzeitig?
Mehrere Nutzer teilen sich den Durchsatz. Für ein Team zählt Bandbreite noch mehr als Speicher.
Wie lange sind deine Texte?
Langer Kontext braucht zusätzlichen Speicher für den Zwischenspeicher des Modells (KV-Cache).
Budget und System?
Bis . Mac, Windows oder Linux: wir zeigen nur, was passt.
Drei Größen, | 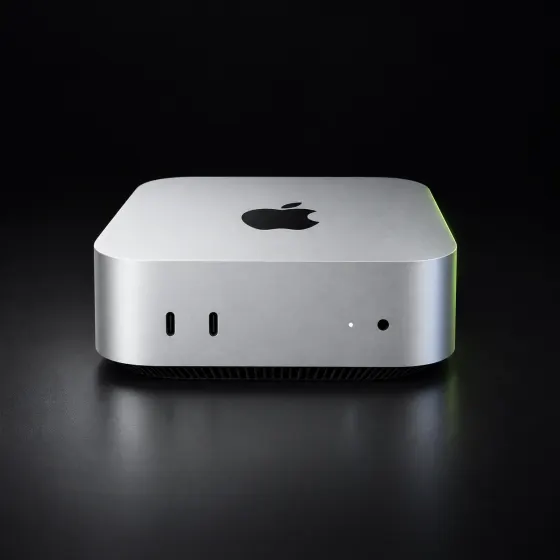 Starterab 839 €einmalig, inkl. USt. | 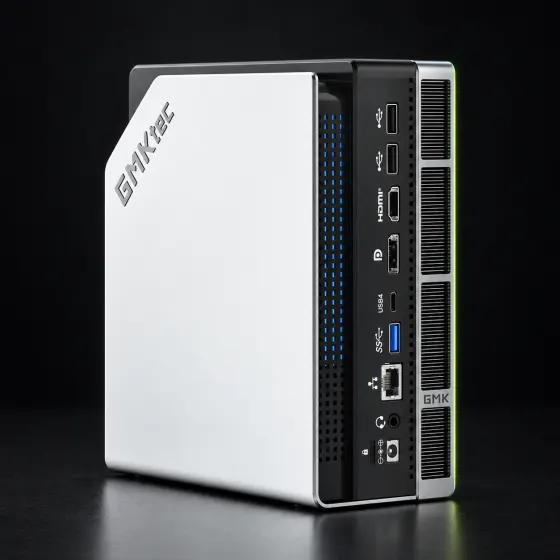 Proab 2 000 €einmalig, inkl. USt. |  Maxab 3 450 €einmalig, inkl. USt. |
|---|---|---|---|
| Speicher für Modelle | 12 bis 24 GB | 48 bis 64 GB | 96 bis 110 GB |
| Bandbreite | 90 bis 307 GB/s | 90 bis 256 GB/s | 256 bis 273 GB/s |
| Größtes Modell | Qwen3 32B | Llama 3.3 70B | GLM-4.5 Air |
| Flüssig bis | Qwen3 30B-A3B, ~29 tok/s | Qwen3 30B-A3B, ~83 tok/s | GLM-4.5 Air, ~22 tok/s |
| Gedacht für | Einzelne Nutzer, Chat und Code-Hilfe | Entwickler und kleine Teams | Teams, Agenten und die großen MoE-Modelle |
| Boxen im Katalog | 3 Geräte | 3 Geräte | 4 Geräte |
| Ansehen | Starter-Boxen ansehen | Pro-Boxen ansehen | Max-Boxen ansehen |
- Speicher für Modelle
- 12 bis 24 GB
- Bandbreite
- 90 bis 307 GB/s
- Größtes Modell
- Qwen3 32B
- Flüssig bis
- Qwen3 30B-A3B, ~29 tok/s
- Gedacht für
- Einzelne Nutzer, Chat und Code-Hilfe
- Boxen im Katalog
- 3 Geräte
- Speicher für Modelle
- 48 bis 64 GB
- Bandbreite
- 90 bis 256 GB/s
- Größtes Modell
- Llama 3.3 70B
- Flüssig bis
- Qwen3 30B-A3B, ~83 tok/s
- Gedacht für
- Entwickler und kleine Teams
- Boxen im Katalog
- 3 Geräte
- Speicher für Modelle
- 96 bis 110 GB
- Bandbreite
- 256 bis 273 GB/s
- Größtes Modell
- GLM-4.5 Air
- Flüssig bis
- GLM-4.5 Air, ~22 tok/s
- Gedacht für
- Teams, Agenten und die großen MoE-Modelle
- Boxen im Katalog
- 4 Geräte
Alle Boxen,
nach Größe sortiert.
Konfigurator öffnen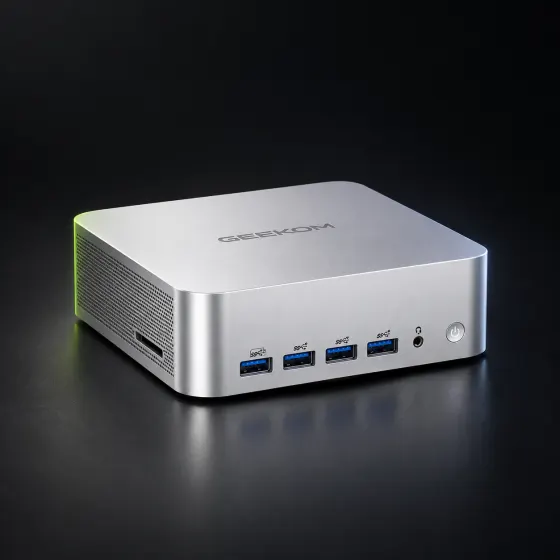 GEEKOM A8 Max 16 GBAMD Ryzen 7 8745HS · Windows12 GB · 90 GB/sPasst bis Gemma 3 12B, flüssig bis Phi-4 Mini839 €GEEKOM
- Minisforum AI X1 Pro 32 GBAMD Ryzen AI 9 HX 470 · Windows24 GB · 90 GB/sPasst bis Qwen3 32B, flüssig bis Qwen3 30B-A3B1 399 €Minisforum
- Apple Mac mini M5 Pro 24 GBApple M5 Pro, 15 Kerne · macOS18 GB · 307 GB/sPasst bis Mistral Small 3.2, flüssig bis gpt-oss-20b1 832 €Amazon
- GMKtec EVO-X2 64 GBAMD Ryzen AI Max+ 395 · Windows48 GB · 256 GB/sPasst bis Llama 3.3 70B, flüssig bis Qwen3 30B-A3B2 000 €GMKtec
- Minisforum AI X1 Pro 96 GBAMD Ryzen AI 9 HX 470 · Windows64 GB · 90 GB/sPasst bis Llama 3.3 70B, flüssig bis Qwen3 30B-A3B2 149 €Minisforum
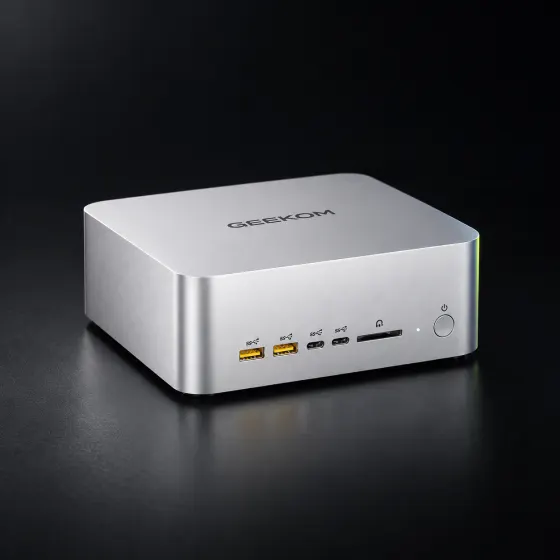 GEEKOM A9 Mega 64 GBAMD Ryzen AI Max+ 388 · Windows48 GB · 256 GB/sPasst bis Llama 3.3 70B, flüssig bis Qwen3 30B-A3B2 499 €GEEKOM
- GMKtec EVO-X2 128 GBAMD Ryzen AI Max+ 395 · Windows96 GB · 256 GB/sPasst bis GLM-4.5 Air, flüssig bis GLM-4.5 Air3 450 €GMKtec
- Beelink GTR9 Pro 128 GBAMD Ryzen AI Max+ 395 · Windows96 GB · 256 GB/sPasst bis GLM-4.5 Air, flüssig bis GLM-4.5 Air4 619 €Beelink
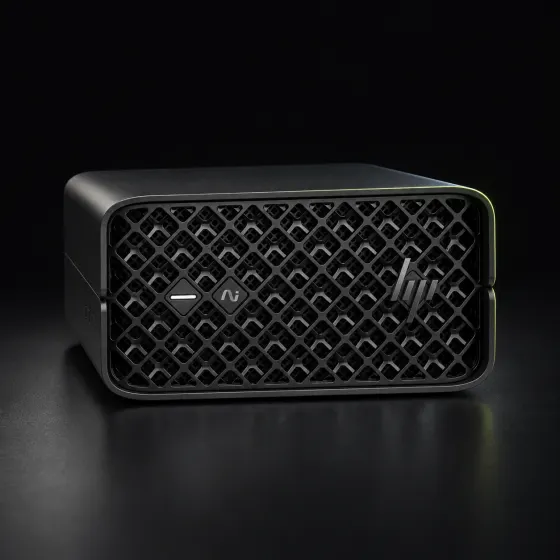 HP Z2 Mini G1a 128 GBAMD Ryzen AI Max+ PRO 395 · Windows96 GB · 256 GB/sPasst bis GLM-4.5 Air, flüssig bis GLM-4.5 Air5 219 €Geizhals
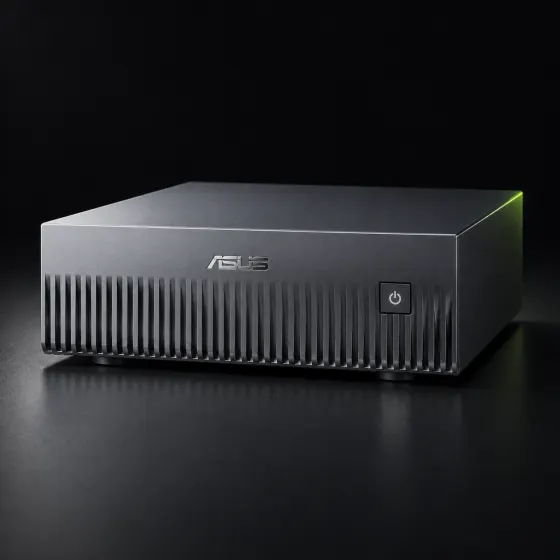 ASUS Ascent GX10 (DGX Spark) 128 GBNVIDIA GB10 Grace Blackwell · Linux110 GB · 273 GB/sPasst bis GLM-4.5 Air, flüssig bis GLM-4.5 Air6 049 €Geizhals
In vier Schritten läuft es.
$ curl -fsSL ollama.com/install.sh | sh
>>> Installing ollama to /usr/local
Ollama läuft auf Port 11434
Zuerst Ollama installieren.
$ ollama pull gpt-oss:120b
pulling manifest
success
Dann das Modell laden.
$ ollama run gpt-oss:120b
>>> Was kostet uns das Modell im Monat?
Nichts außer Strom: es läuft auf deiner Box, ohne Abo und ohne Cloud.
Danach einfach fragen.
$ docker run -d -p 3000:8080 ghcr.io/open-webui/open-webui:main
Open WebUI auf http://llmbox.local:3000
6 Nutzer angemeldet, Daten bleiben im Haus
Zuletzt fürs Team öffnen.
Ehrliche
Antworten.
Warum zählt der Speicher mehr als der Prozessor?
Ein Modell muss komplett in den Speicher passen, den die Grafikeinheit nutzen darf, sonst startet es nicht. Und beim Antworten liest es pro Token seine aktiven Gewichte aus genau diesem Speicher. Ein 70B-Modell in 4 Bit sind rund 42 GB pro Token: bei 256 GB/s sind physikalisch höchstens sechs Token pro Sekunde drin, egal wie schnell die CPU ist.
Woher kommen eure Token pro Sekunde?
Wir rechnen Bandbreite geteilt durch die pro Token gelesenen Gigabyte, mal 0,65 für die Verluste in der Praxis. Das trifft veröffentlichte Messungen gut: gpt-oss-120b liegt auf Strix-Halo-Boxen je nach Software zwischen 30 und 50 Token pro Sekunde. Sobald wir ein Gerät selbst vermessen haben, ersetzt der Messwert die Schätzung.
Warum keine Grafikkarte?
Eine RTX 5090 hat 32 GB und ist bei Modellen bis 24B unschlagbar schnell. Alles darüber passt nicht hinein. Mini-PCs mit 64 oder 128 GB gemeinsamem Speicher sind langsamer, aber sie führen die großen Modelle überhaupt aus, leise und mit 120 bis 140 Watt unter Last.
Mac mini oder Windows-Box?
Der Mac mini M5 Pro hat mit 307 GB/s die höchste Bandbreite im Katalog und ist der flüssigste Einstieg für Modelle bis 24B. Die Strix-Halo-Boxen mit 128 GB sind die günstigste Art, gpt-oss-120b oder Llama 4 Scout auszuführen. Ollama und LM Studio laufen auf beiden.
Was heißt MoE?
Mixture of Experts: Das Modell besteht aus vielen Teilnetzen, pro Token rechnen nur wenige davon. gpt-oss-120b hat 117 Milliarden Parameter, aktiv sind pro Token rund 5 Milliarden. Es braucht also den Speicher eines großen Modells, antwortet aber im Tempo eines kleinen.
Bleiben meine Daten wirklich im Haus?
Ja. Ollama, LM Studio und Open WebUI laufen vollständig lokal. Nach dem Download der Modelle braucht die Box kein Internet. Für Kanzleien, Praxen und alle mit DSGVO-Pflichten ist genau das der Grund für eine eigene Box.
Verdient ihr an den Links?
Ja. Die Links zu den Herstellern sind Partnerlinks. Kaufst du darüber, bekommen wir eine Provision, dein Preis bleibt gleich. Welche Box wir empfehlen, entscheidet die Rechnung oben, nicht die Provision: deshalb stehen auch Geräte ohne Partnerprogramm im Katalog.
Und wenn mein Modell in keine Box passt?
Qwen3 235B oder DeepSeek V4 brauchen über 128 GB. Dafür lassen sich zwei Boxen koppeln (DGX Spark über ConnectX, Strix-Halo-Boxen über llama.cpp im Netzwerk) oder du greifst zu einem Mac Studio mit 256 GB. Für die meisten Aufgaben reicht ein MoE-Modell bis 120B.